
Última actualización: 22 de noviembre de 2026
Un concepto para el SEO internacional en la búsqueda con IA, con datos de España, México y Argentina y un método para medirlo en cualquier mercado que comparta idioma con otros.
En 30 segundos
- Qué es: la IA responde en el idioma del usuario, como si fuera local, pero cita fuentes escritas para otro país y no lo avisa.
- Cuánto pasa: en preguntas de producto desde México y Argentina sin nombrar el país, 34 de 36 respuestas de Google AI Mode citaban webs españolas. Ninguna lo decía.
- Dónde no pasa: en seguros de auto, 0 fuentes españolas y 95% locales.
- Se cuela hasta en las palabras: las respuestas sobre aspiradoras robot que citaban webs españolas usaban “fregar” o “fregona” en 16 de 23 casos, aunque el usuario hubiera escrito “trapear”.
- Cómo medirlo: siete pasos, cuatro métricas, plantilla y datos descargables al final.
Le pregunté a Google AI Mode, desde Ciudad de México, cuál es la mejor aspiradora robot calidad-precio. Como opción económica recomendó una Cecotec Conga, una marca valenciana, con un precio aproximado de “90€ – 170€ según ofertas”. La fuente de ese dato era la sección de compras de El País. En ningún momento la respuesta mencionó España.
No es un caso aislado. En la misma prueba, 17 de 18 respuestas sobre aspiradoras robot desde México y Argentina citaban webs españolas, y ninguna lo decía. La forma más clara la conté en este artículo de LinkedIn: una respuesta sobre cafeteras escrita con giros mexicanos y con todas sus fuentes españolas.
La respuesta se dirige al usuario como si fuera local, y aun así las pruebas son de otro país. A eso lo llamo localización de superficie.
Qué es la localización de superficie
La localización de superficie es cuando una respuesta de IA adapta el idioma o la variante al usuario, pero saca sus pruebas de otro mercado y no lo dice.
Tienen que darse tres condiciones a la vez:
- La respuesta se presenta como local. Está en el idioma del usuario y no se dirige a otro mercado. En su forma más clara, además usa la variante del país del usuario.
- La evidencia es de otro mercado. Las fuentes citadas están escritas para otro país, con sus tiendas, sus precios y sus normas.
- No hay aviso. La respuesta no dice de dónde vienen las pruebas.
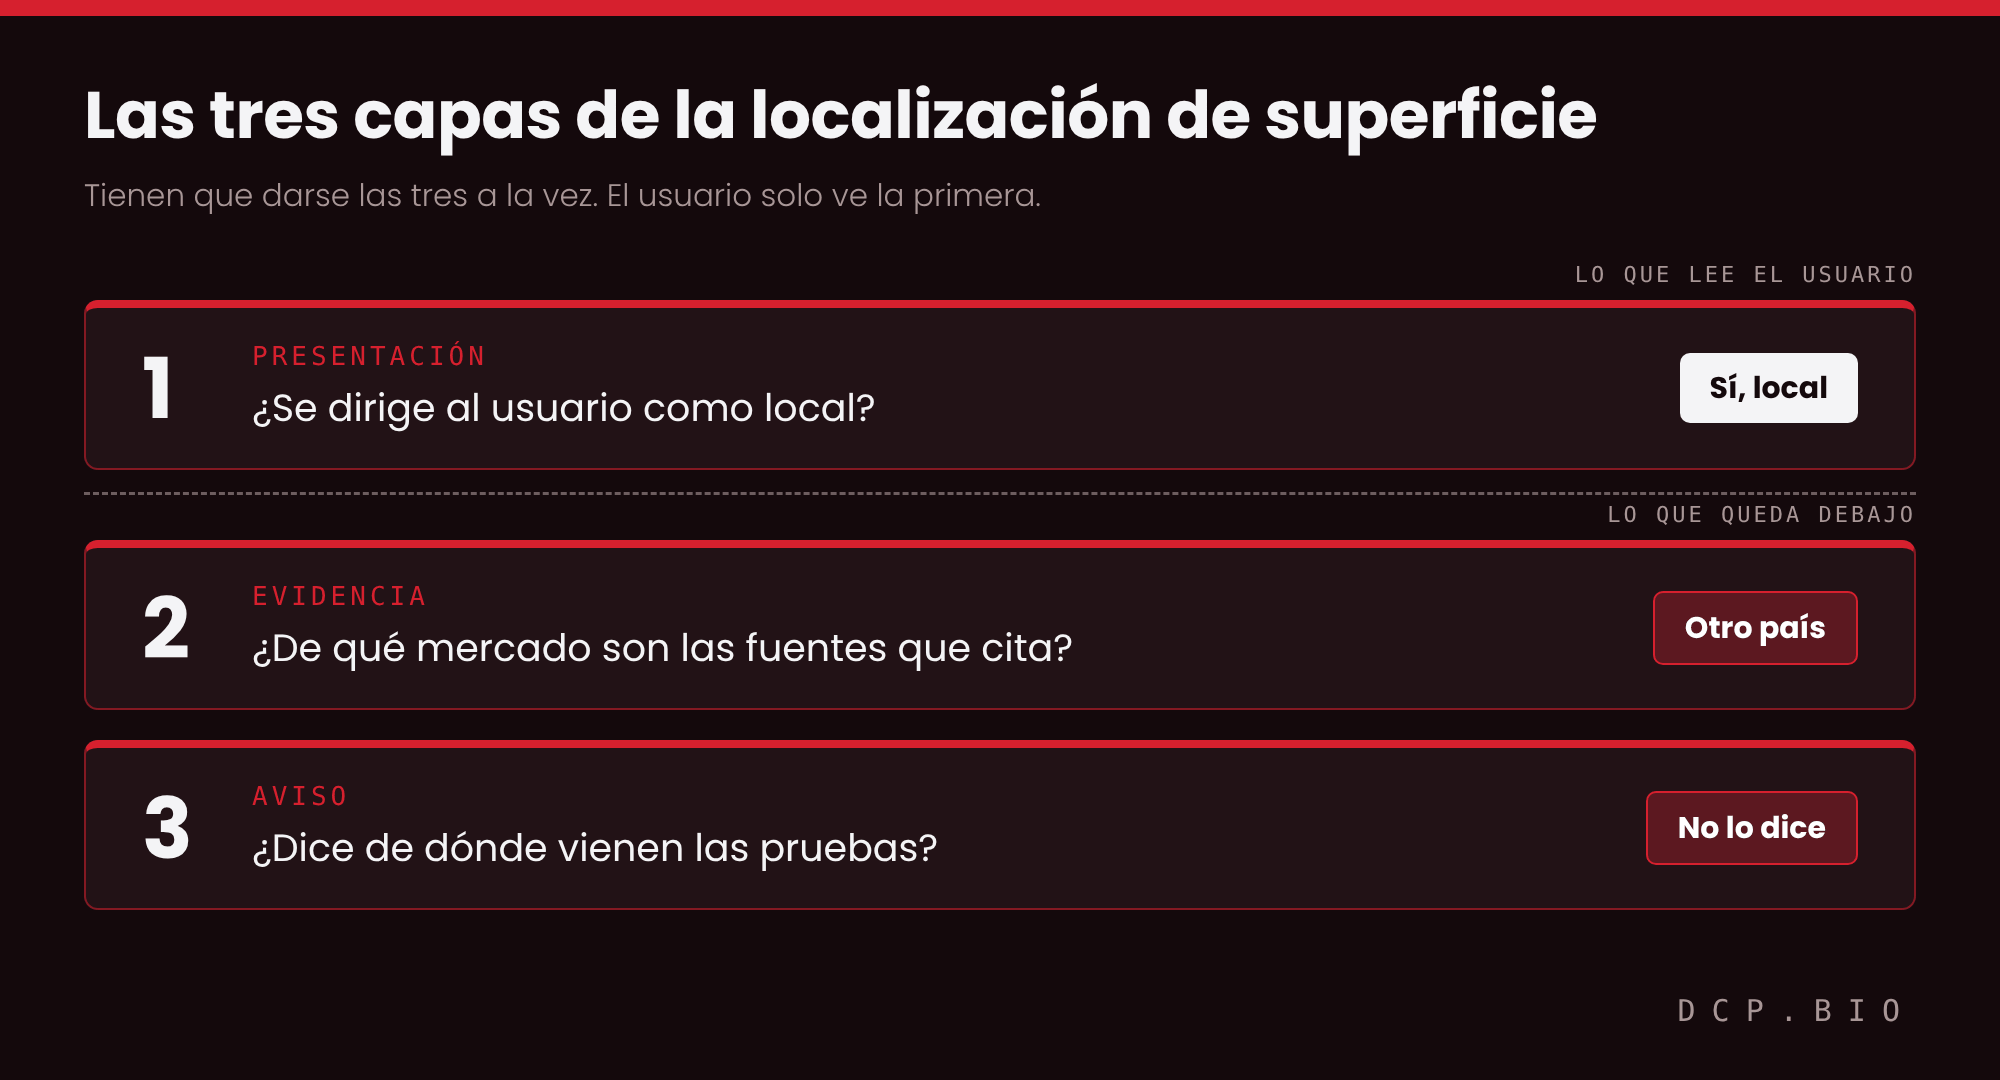
El usuario solo ve la primera capa. Por eso este fallo es más difícil de detectar que los otros con los que se suele confundir:
- El error de marco, cuando preguntas desde México cómo darte de alta como autónomo y te explican el régimen español, se ve. El contenido no sirve y cualquiera lo nota.
- El error de dialecto, un “ordenador” en una respuesta para México, también se ve.
- En la localización de superficie no hay nada raro en el texto. Solo se descubre abriendo las fuentes, y casi nadie las abre.
Para medirlo propongo una cifra, la tasa de localización de superficie: el porcentaje de respuestas que citan al menos una fuente de otro mercado sin avisarlo.
Tres precisiones para que la cifra signifique lo mismo en manos de cualquiera:
- “Otro mercado” es una fuente escrita para un país concreto que no es el del usuario, según su moneda, sus tiendas o su normativa. La web global de una marca, una fuente en inglés sin país, Amazon.com, YouTube o Reddit no cuentan como extranjeras: van a una categoría aparte, “sin país asignable”. En mi réplica fueron entre el 5% y el 15% de las citas.
- La tasa da por cumplida la condición 1 cuando la respuesta está en el idioma del usuario. No mide si la variante es la de su país. Más abajo hay una primera codificación de la variante, y lo que sale es revelador.
- El umbral de “al menos una fuente” es generoso. Por eso doy también una versión estricta: respuestas en las que las fuentes de otro mercado superan a las locales.
En mi réplica con Google AI Mode, en preguntas de producto sin nombrar el país desde México y Argentina, la tasa fue de 34 de 36 respuestas. En la versión estricta, 29 de 36.
Qué se sabía ya
Este fenómeno tiene antecedentes, y conviene separar lo que ya estaba dicho de lo que aportan estos datos.
Motoko Hunt describió en Search Engine Journal, en noviembre de 2025, lo que llama “geo drift” (en inglés): respuestas que en la superficie parecen localizadas y por debajo están hechas con datos de otro mercado, “English data wearing a different flag”. Es la referencia más cercana, pero describe otro problema: contenido en inglés que se presenta en otro idioma. La localización de superficie es el caso en el que el idioma ya coincide: misma lengua, otro país y ningún aviso. Hunt ya avisaba de que una pregunta en español puede venir de México, Colombia o España, recogía una prueba de Blas Giffuni en la que una búsqueda de proveedores industriales en México devolvía una lista de Estados Unidos traducida, y proponía apuntar de qué mercados son las fuentes que cita la IA. Su foco es el inglés colándose en otros idiomas, y el artículo no incluye una medición sistemática.
Desde la investigación, un equipo de Google Research y la Universidad Bar-Ilan publicó en ACL 2026 “Location Not Found” (en inglés). Separa la fluidez lingüística de la localización y mide, con 2.156 preguntas sin pista de lugar en 12 idiomas, que los modelos tienden a responder con normas de Estados Unidos aunque se les pregunte en otro idioma. Veselovsky y otros hablan del “explicit–implicit localization gap” (en inglés): el modelo tiene el conocimiento local, pero no lo usa si no se le pide de forma explícita.
En el lado de las fuentes, el trabajo más cercano viene de mercados de habla alemana. Con datos de Stellarcast, Ulrike Langer explicó en News Machines que, al preguntar en inglés, los medios alemanes desaparecen de la mayoría de respuestas. Desde Zúrich, el fög (en alemán) midió el caso contrario: cuando la pregunta nombra Suiza, los medios suizos pasan a ser la fuente más citada. Y Gianluca Fiorelli lleva tiempo defendiendo que los LLM confunden idioma con ubicación (en inglés), y cita como riesgo habitual una web en español que sirve a la vez a España y a México.
Lo que añade este trabajo es acotar ese caso y medirlo. Fiorelli lo apunta como riesgo. Hasta donde sé, esta es la primera medición del caso dentro del mismo idioma y entre países, en las fuentes que cita la IA cuando busca (no en lo que el modelo “sabe”), con la condición de no aviso y comparando con lo que enseña Google para la misma pregunta.
Hay un contraste que me parece lo más interesante, con una salvedad: no se mide lo mismo. El paper de Google mira lo que el modelo sabe, y yo miro lo que recupera cuando busca. Allí, el sesgo entre países que comparten idioma sigue el tamaño de la población. En la recuperación, mis datos van en sentido contrario: México tiene casi tres veces la población de España y aun así sus fuentes pierden. Mi hipótesis es que, cuando la IA busca, no manda la población. Manda quién publica el formato que la IA quiere citar.
De dónde sale
La idea no viene de un estudio suelto:
- Marzo, en Search Engine Land: el problema del Global Spanish, la IA trata más de 20 mercados como uno.
- Abril: un marco de SEO cultural. Si el contenido no declara su mercado, el modelo lo rellena con un valor por defecto.
- Mayo: Cataluña enseña que los fondos de fuentes se separan por idioma.
- Octubre: el póster de Search Central Live Deep Dive Europe. De 76 respuestas desde un contexto mexicano, 16 desarrollaban el marco de otro país y otras 9 no llegaban a decir de qué país hablaban. Y un experimento con las búsquedas de fondo de ChatGPT: buscan donde creen que está la autoridad, no en el idioma del usuario.
- Noviembre: el estudio con Stellarcast y la réplica de este artículo. Con productos neutros, el fallo ya no se nota en el texto.
Las pruebas
1. Réplica en tres categorías
El 20 de noviembre de 2026 lancé 162 consultas a Google AI Mode con DataForSEO, desde Madrid, Ciudad de México y Buenos Aires. Eran tres categorías con tres preguntas cada una, con y sin el país en la pregunta y tres repeticiones. Las preguntas usaban el vocabulario de cada país: “robot aspirador”, “seguro de coche” y “que también friegue” en España. “Aspiradora robot”, “seguro de auto” y “que también trapee” en México. Y “aspiradora robot”, “seguro de auto” y “que también pase el trapo” en Argentina.
| Desde México y Argentina | Fuentes españolas, sin país | Fuentes españolas, con país | Fuentes locales, sin país |
|---|---|---|---|
| Café | 39 de 77 (51%) | 22 de 87 (25%) | 15 de 77 (19%) |
| Aspiradora robot | 36 de 73 (49%) | 12 de 73 (16%) | 13 de 73 (18%) |
| Seguro de auto | 0 de 82 (0%) | 0 de 75 (0%) | 78 de 82 (95%) |
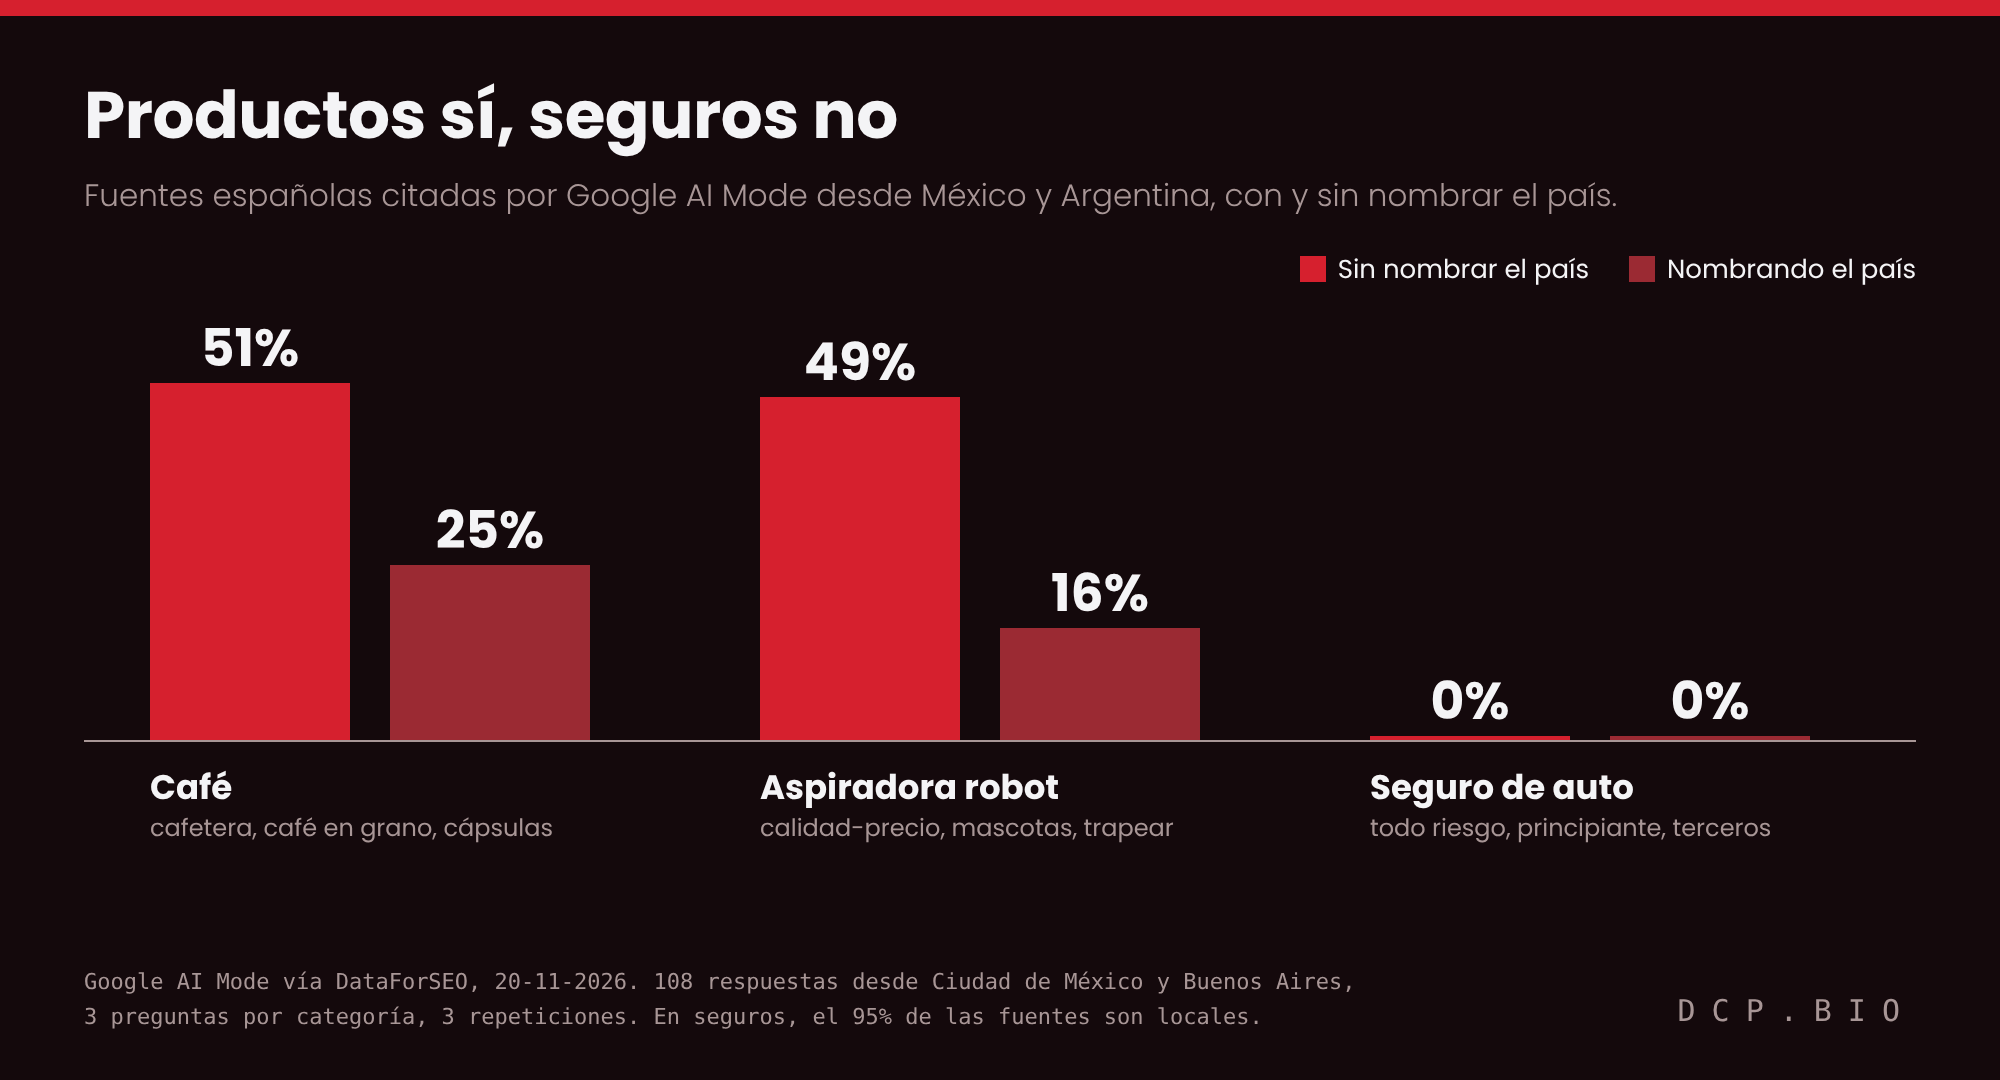
Lo que enseña:
- El patrón se repite fuera del café. Desde Ciudad de México y sin nombrar el país, ninguna de las 35 fuentes citadas sobre aspiradoras robot era mexicana. Las 13 locales de la tabla son todas de Buenos Aires.
- Con productos, nombrar el país reduce la fuga, pero no la arregla. La tasa baja de 34 de 36 respuestas a 17 de 36, y en café una de cada cuatro citas sigue siendo española. Esto matiza lo que contamos del estudio con Stellarcast, donde nombrar el país dejaba las fuentes españolas en 2 de 72 respuestas. Pero allí las preguntas que nombraban el país eran otras (suscripciones, dónde comprar café recién tostado, tostadores, marcas sostenibles) y se lanzaron en tres motores. Aquí son preguntas de producto y solo en AI Mode. Mi lectura es que nombrar el país funciona muy bien cuando la pregunta ya es local, y se queda corto cuando el producto se vende en todas partes.
- En seguros no hay fuga. No es por el vocabulario, que también usé en aspiradoras. Mi hipótesis es la jurisdicción: hay aseguradoras locales, comparadores locales y organismos con contenido propio, como la Condusef en México, que aparece citada una y otra vez.
- Ninguna avisa. De las 51 respuestas desde México y Argentina que citaban webs españolas, ninguna mencionaba España.
2. La IA no hereda la fuga de Google, la cambia
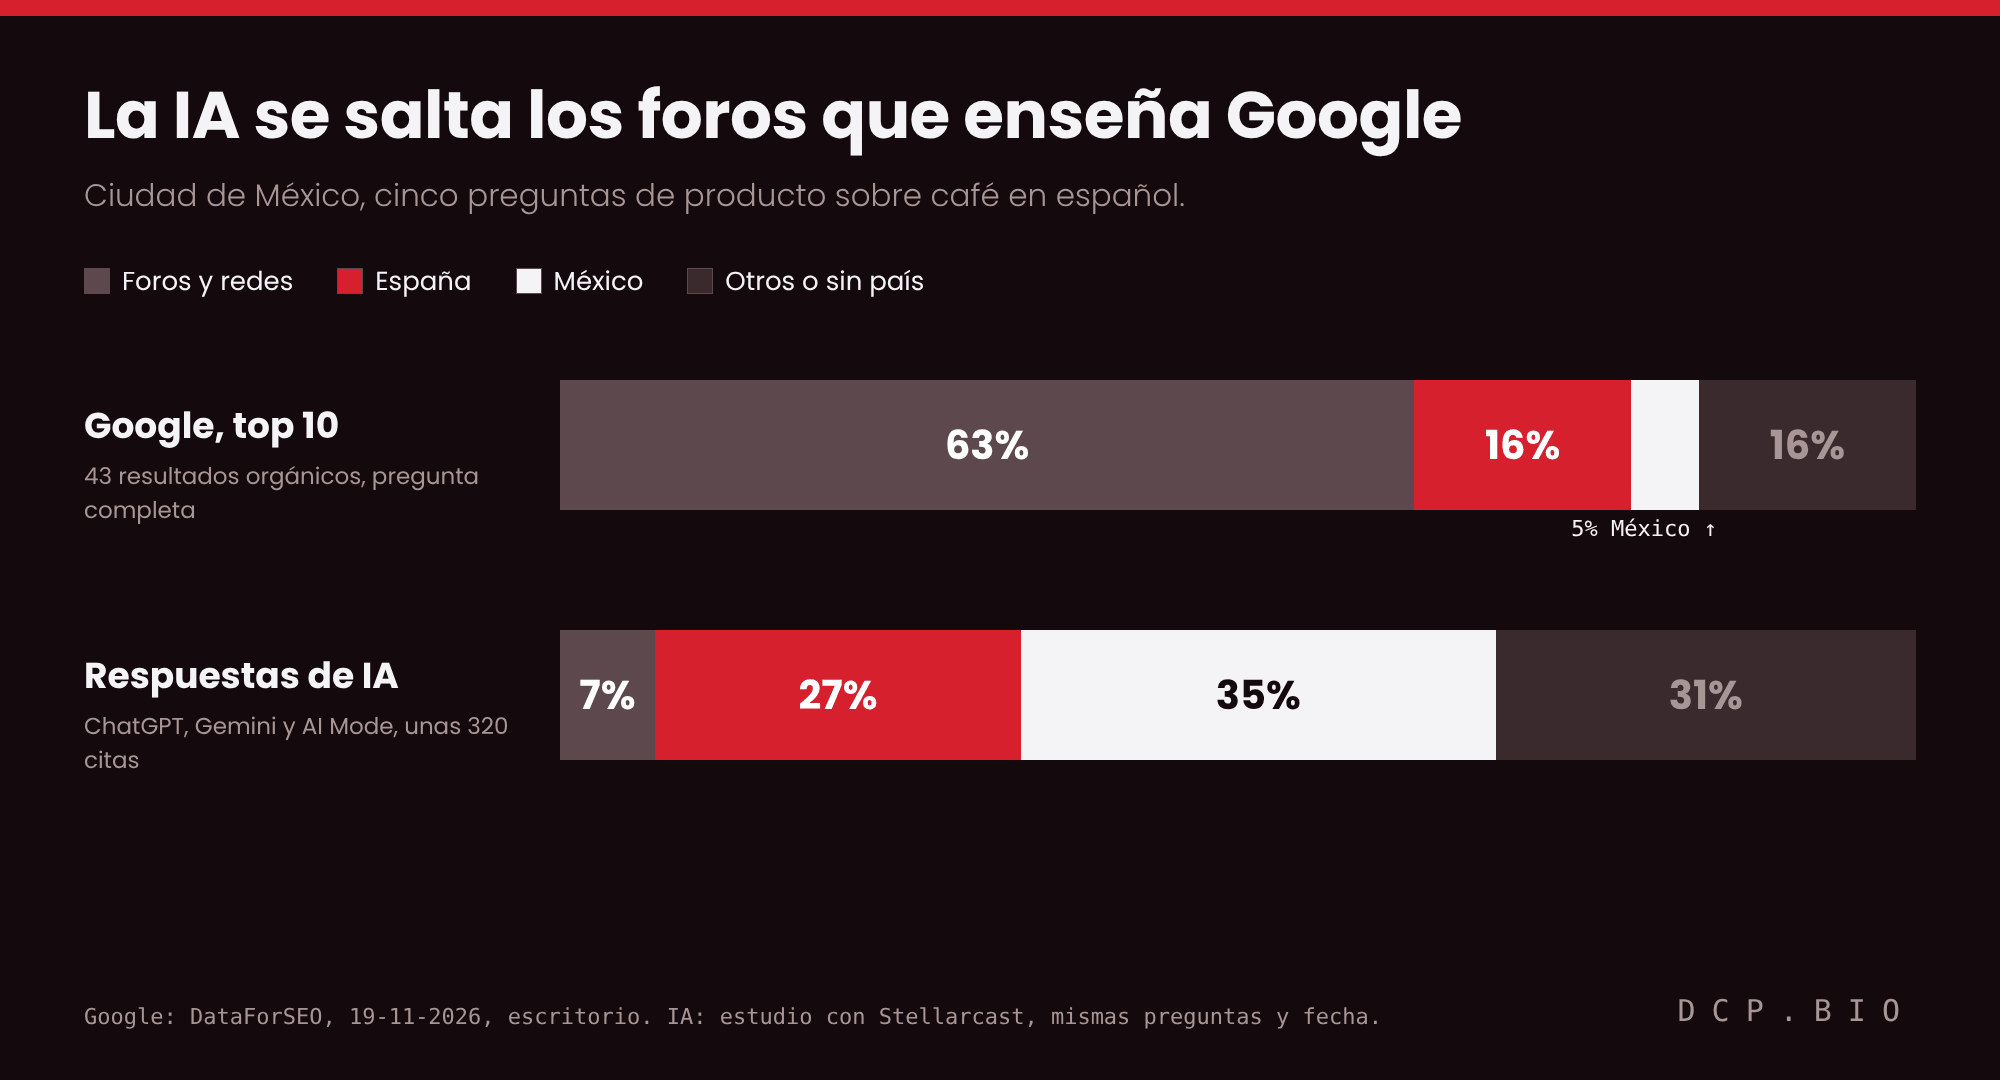
Gemini y AI Mode tiran del índice de Google, así que el 19 de noviembre, el mismo día en que se recogieron las respuestas del estudio con Stellarcast, saqué con DataForSEO 30 páginas de resultados para sus cinco preguntas de producto sobre café.
Con la pregunta escrita completa desde Ciudad de México, Google ya mostraba más resultados editoriales españoles que mexicanos: 7 frente a 2 en las cinco preguntas. Pero la mayor parte de la página eran foros y redes: 27 de 43 resultados.
Las respuestas de IA del estudio (ChatGPT, Gemini y AI Mode juntos) hacen otra cosa. Solo el 7% de sus citas en México venían de foros y redes, y de 85 citas españolas, solo 21 eran de dominios que estaban en el top 10 de Google para esa pregunta. En Argentina, 0 de 90. La IA no copia la fuga de Google. Busca más allá y trae fuentes españolas con más autoridad que las que enseña Google.
3. El estudio con Stellarcast
Con Somya Goyal analizamos 1.065 respuestas de cuatro motores a 14 preguntas sobre café. De ese estudio me quedo con tres cifras que encajan con la definición:
- En preguntas de producto sin país, el 29% de las fuentes citadas desde México y Argentina eran españolas. En preguntas sobre negocios locales, el 2%.
- 119 de 175 de esas citas eran exactamente las mismas URL que se citaban desde España.
- 1 de 69 respuestas que citaban webs españolas mencionaba España.
El resto de cifras y la metodología están en el informe completo (en inglés).
4. La fuga también se cuela en las palabras
Para comprobar la condición 1 codifiqué la variante de las respuestas desde México y Argentina con un léxico sencillo. Como marcas de España usé “fregar”, “fregona”, “fregado”, “coche”, “ordenador” y “vosotros”. Como marcas locales, “trapear”, “auto”, “celular” y “computadora” en México, y el voseo (“tenés”, “querés”, “podés”) en Argentina.
En café casi no hay palabras que cambien de un país a otro, y la mayoría de respuestas salen neutras. En aspiradoras robot, donde “fregar” y “trapear” son el mismo concepto con palabra distinta, el vocabulario de las fuentes gana al del usuario:
| Respuestas sobre aspiradoras robot desde México y Argentina | Usan palabras de España |
|---|---|
| Citan webs españolas | 16 de 23 |
| No citan webs españolas | 2 de 13 |
Aunque la pregunta dijera “que también trapee”, varias respuestas mezclaban “trapear” con “fregona”. En Argentina aparecían respuestas con voseo y “fregado” en la misma frase: la gramática del usuario y las palabras de la fuente.
Esto matiza la definición. La localización de superficie no siempre es una capa local perfecta encima de pruebas extranjeras. A menudo la superficie también se agrieta, y por las grietas se ve de dónde vienen las fuentes. Es un léxico pequeño, aplicado a 36 respuestas y a una sola categoría, así que lo tomo como una pista que habrá que medir mejor, no como una cifra cerrada.
Mi lectura de las cuatro pruebas es la misma: no es un sesgo hacia España como país, es un sesgo hacia un formato. Las guías de compra de “los mejores X” con enlaces de afiliación las producen sobre todo medios españoles. Donde ese formato manda, como en los productos que se venden en todas partes, España gana. Donde manda la jurisdicción, no.
Cómo medirlo en tu mercado
El método está pensado para cualquier idioma que compartan varios países. Lo he probado en español. El catalán y el caso alemán de Stellarcast sirven de contraste, porque muestran el papel del idioma y de la ubicación, pero no la fuga entre países que comparten idioma. La plantilla del final tiene todas las columnas.
1. Escribe tres tipos de preguntas. Producto global (algo que se vende igual en todas partes), negocio local (depende de dónde estés) y jurisdicción (tiene normas propias: seguros, impuestos, trámites). Usa el vocabulario de cada mercado.
2. Lanza cada pregunta con y sin el país, desde cada ciudad, tres veces. Las respuestas cambian de una ejecución a otra.
3. Clasifica cada fuente leyendo la web, no el dominio. Fíjate en la moneda, las tiendas, los teléfonos y la normativa. Las fuentes que no puedas asignar a un país, apúntalas aparte y dilo.
4. Calcula cuatro métricas:
- Tasa de localización de superficie: respuestas que citan al menos una fuente de otro mercado sin avisarlo. Referencia: 34 de 36 en productos sin país (réplica, solo AI Mode, 20 de noviembre). Versión estricta: 29 de 36.
- Cuota de fuentes extranjeras, por tipo de pregunta. Referencia: 29% en preguntas de producto y 2% en negocio local (estudio con Stellarcast, ChatGPT, Gemini y AI Mode, respuestas en español desde México y Argentina).
- Coincidencia de URL con el mercado dominante. Referencia: 119 de 175 (estudio con Stellarcast).
- Efecto de nombrar el país: la diferencia con y sin país. Te dice si el problema se arregla con una palabra o es estructural.
5. Compara con Google. Saca el top 10 para la pregunta completa y para la keyword corta, y compáralo con lo que cita la IA. Las dos dan fotos muy distintas: en mis datos desde Ciudad de México, los foros y redes bajaban de 27 de 43 resultados con la pregunta completa a 16 de 47 con la keyword corta, y los resultados mexicanos subían de 2 a 5. Mirar solo una de las dos te da media foto.
6. Revisa cómo se declaran las fuentes extranjeras. Mira el hreflang y el idioma de la página de las más citadas. En mi caso, las tres guías españolas más citadas sobre cafeteras eran estas:
| Guía | hreflang | Idioma de la página |
|---|---|---|
| La Vanguardia, /comprar/ | Ninguno | es |
| ABC, /favorito/ | Ninguno | es |
| ¡Hola!, /seleccion/ | es | es |
Ninguna declara que escribe para España. Probablemente un es-ES no cambiaría mucho, porque la recuperación trabaja con significado. Pero sin él, el modelo no tiene ninguna señal explícita del mercado.
7. Haz la prueba del carrito. Busca lo recomendado en las tiendas del mercado del usuario. En el caso de la cafetera desde México, solo 2 de los 7 modelos recomendados aparecían con precio en Amazon México. Es la forma más rápida de explicárselo a un cliente o a una redacción.
Para las respuestas con ubicación por ciudad he usado Google AI Mode a través de DataForSEO.
Qué hacer con el resultado
- Medio local: el hueco suele ser de formato, no de información. Si en tu mercado no hay guías de compra con tiendas y precios locales, las ocupará alguien de fuera.
- Medio del mercado dominante: recibes visibilidad donde probablemente no puedes monetizar. Declara para quién es cada guía.
- Marca: tu visibilidad en IA en un país puede ser, en parte, tu cobertura en la prensa de otro. Mide por mercado, con y sin país, antes de fiarte de un informe de visibilidad.
Si tu web sirve a varios países con el mismo idioma, la parte técnica está en SEO técnico internacional y la decisión de mercado, en la brújula de las 5 Cs.
Esta página declara hreflang “es” y no “es-ES”. La escribo desde España, pero el método vale para cualquier mercado hispanohablante.
Límites
- La réplica es solo Google AI Mode, un día, tres preguntas por categoría y tres ejecuciones. No incluye ChatGPT ni Gemini.
- Entre el 5% y el 15% de las fuentes citadas desde México y Argentina no se pudieron asignar a un país (15% en aspiradoras, 14% en café y 5% en seguros). No cuentan ni como locales ni como españolas.
- Los dominios están clasificados a mano, por una sola persona.
- La comparación con Google es una página de resultados de escritorio por consulta, en un solo día y solo para café.
- El estudio con Stellarcast es de café, con una ronda de recogida. Perplexity iba sin ubicación.
- La prueba del carrito es una búsqueda en una sola tienda.
- La codificación de la variante usa un léxico pequeño y solo es informativa en categorías con palabras que cambian entre países.
Todo esto enseña un mecanismo y cuándo aparece, no una tasa para todos los sectores.
Datos y plantilla
- Plantilla de auditoría (CSV).
- Réplica en Google AI Mode, 20 de noviembre de 2026 (CSV, 734 citas).
- Réplica, una fila por respuesta (CSV, 162 respuestas, con la codificación de la variante).
- SERPs de Google, 19 de noviembre de 2026 (CSV, 30 páginas de resultados).
- Informe del estudio con Stellarcast (en inglés).
Los datos se publican con licencia CC BY 4.0: puedes reutilizarlos y adaptarlos citando la fuente.
El resto de mi investigación sobre mercados que comparten idioma está en la página de investigación.
Para citar este trabajo: Carrasco Pamies, D. (2026). Localización de superficie: la IA te responde en tu español y te cita fuentes de otro país. dcp.bio. https://dcp.bio/localizacion-superficie/
Si lo mides en tu mercado, me gustaría ver los resultados. Sobre todo si encuentras una categoría de producto donde no pase.
Y si tu marca vende en varios mercados que comparten idioma y quieres saber qué cita la IA en cada uno, es parte de lo que hago como consultor SEO internacional.